2026-09-10 · AI 资讯
DeepSeek V4.1 Flash 登场:原生多模态与超高性价比优化
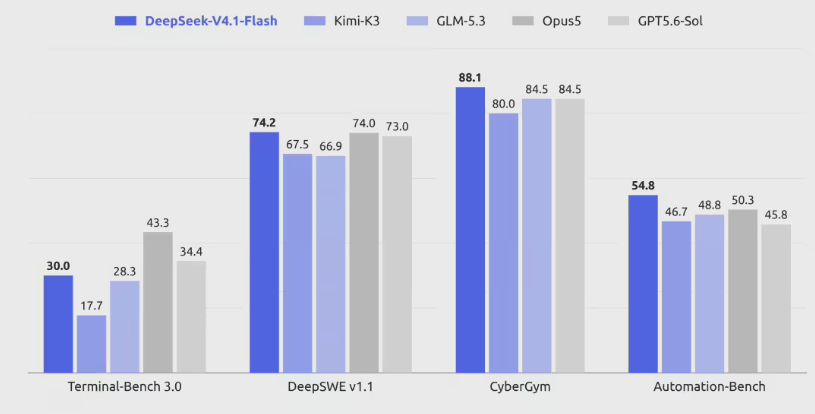
深度求索发布 DeepSeek V4.1 Flash,该模型旨在通过更强的能力上限与推理吞吐量引领轻量化模型潮流。凭借全新的 MoE 架构,它实现了在降低硬件资源消耗的前提下,大幅提升模型理解与生成能力。
在效率方面,KV Cache 的极致压缩使得该模型对基础设施的需求大幅降低,尤其是相比初代模型,缓存需求缩减至 1/437。这使得 Agent 类应用在复杂上下文下的运行成本大幅下降,为开发者提供了更具性价比的选择。
随着 V4.1 Flash 的上线,DeepSeek 对产品线进行了整合,旧版模型陆续下线并平滑过渡至新版本。同时,新定价策略已于 9 月 10 日生效,通过峰谷分时计费模式,鼓励用户更灵活地调配计算任务,进一步普惠大模型应用开发。