2026-09-11 · AI 资讯
小米开源工业级目标说话人语音识别大模型 CocktailASR-1
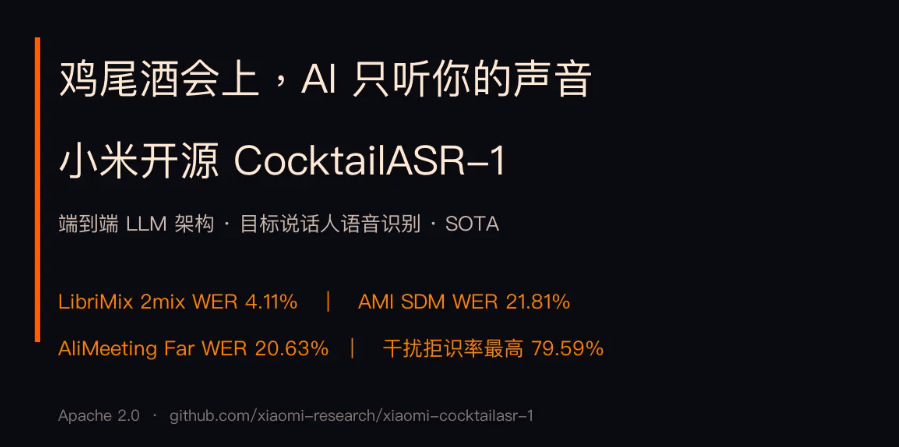
小米近日正式开源了工业级目标说话人语音识别大模型 CocktailASR-1,旨在彻底攻克多人同时讲话的“鸡尾酒会难题”。该模型采用基于参考声纹的目标说话人识别机制,用户只需提供一段短参考音频,系统便能利用声纹嵌入在复杂的混合音频中精准锁定并转录特定人物的语音,同时自动过滤其他人声、混响与背景噪声。
在底层架构上,CocktailASR-1 采用端到端大语言模型架构,由 D2V2 音频编码器、Adapter 以及大模型解码器串联组成并整合在单一检查点中。基准测试显示,其在多说话人测试集如 LibriMix2mix 和 LibriSpeechMix2mix 上的字错率分别低至 4.11% 和 2.90%,在更极端的混合与真实会议场景中大幅领先同赛道竞品。
除了出色的识别精度外,该模型还具备强大的负样本拒识能力与思维链推理功能,能有效防止智能设备被旁人声音误触发并提升系统可解释性。目前,相关代码已在 GitHub 按照 Apache 2.0 协议开源,为语音识别技术从“捕获所有声音”向“锁定目标声音”的演进树立了新的行业里程碑。